你准备把一个 Coding Agent 接入日常代码审查。公开 benchmark 告诉你,它在某套任务上得分不错;但轮到自己的仓库,它能不能发现真正会影响生产的错误?
这个问题不能只靠模型排名回答。代码审查发生在具体仓库里:架构约束、发布流程、隐含契约和历史事故,都会改变“好审查”的标准。真正有用的评测,需要把这些上下文变成可重复执行的任务。
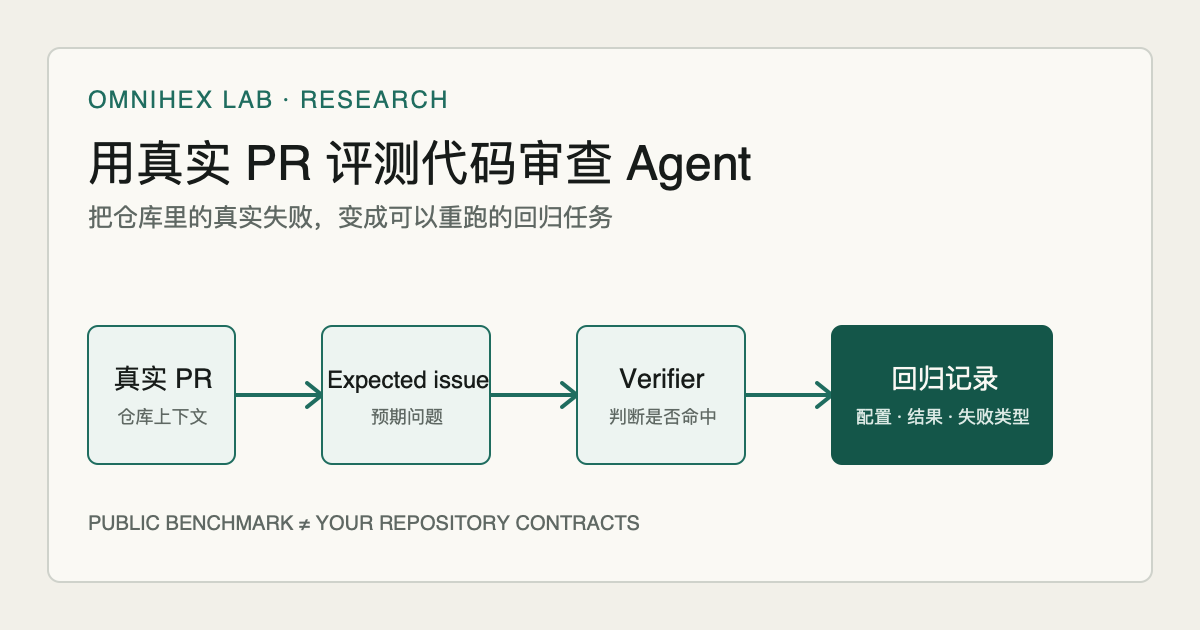
LangChain 的 ReviewBench 提供了一个值得拆解的样本:从真实 Pull Request 及其人工审查评论中构造任务,再用 verifier 判断 Agent 是否找到了预期问题。Harbor 的任务结构 则提供了把环境、指令、测试和验证逻辑固定下来的执行框架。两者合在一起,给独立开发者的启发不是“照抄一个分数”,而是建立自己的代码审查回归集。
为什么公开 benchmark 不够
公开 benchmark 适合回答一类通用问题:在统一任务和统一评分方式下,不同配置表现如何。它的价值在于可比较,而不是替你定义仓库的质量标准。
真实仓库里,代码审查往往依赖三类公开 benchmark 很难完整覆盖的知识:
- 架构约束:某个模块必须通过哪一层访问数据,哪些逻辑不能落在页面组件里。
- 发布契约:草稿不能进入生产 RSS、预览环境必须
noindex、生产分支只能 fast-forward。 - 失败历史:过去哪些改动曾漏掉边界条件、破坏兼容性,或者让静态构建生成错误页面。
如果任务不包含这些信息,Agent 即使给出合理建议,也不一定抓住真正值得阻断合并的问题。
ReviewBench 做了什么
ReviewBench 的核心做法,是从内部 LangSmith monorepo 的真实 PR 和人工审查评论中整理代码审查任务。任务不要求 Agent 修改代码,而是要求它阅读变更并提出 finding;随后由 verifier 判断 finding 是否与预期问题匹配。
这比单纯比较“生成的代码能不能通过测试”更接近审查工作本身,因为审查输出通常是自然语言,而且同一个问题可能有多种正确表述。Verifier 因而不能只做字符串匹配,而要判断:
- finding 是否指向正确位置;
- 是否识别了同一个行为问题;
- 是否说明了足以影响合并决策的后果。
这里的关键不是“让 Agent 多说”,而是让它找到预先定义的高价值问题。
真实 PR 为什么更难
真实 PR 不是孤立的代码片段。一个几行的改动,可能依赖仓库其他位置的过滤规则、构建环境或数据约定。审查者需要沿调用路径理解变化,而不是只看 diff 表面。
这也解释了为什么代码审查评测不能等同于 Coding Agent 的总体能力评测。代码生成、自动修复、命令执行与代码审查有不同的输入、输出和失败方式。ReviewBench 聚焦的是其中一个更窄的问题:Agent 能否从真实改动里识别应当被指出的问题。
Harbor 如何把任务固定下来
Harbor 将一项评测任务拆成相互独立的层:任务描述、可运行环境、参考解决方案、测试与 verifier。这样的分层让评测可以重跑,也让失败更容易归因。
对代码审查任务,可以把它映射为:
- Task:告诉 Agent 审查哪个 PR,以及允许读取哪些仓库上下文;
- Environment:固定到评测时的仓库状态和依赖;
- Expected issue:保存人工审查已经确认的关键问题;
- Verifier:判断 Agent 的 finding 是否命中位置、行为和影响;
- Trial record:保存配置、输出、判定和失败类别。
Harbor 提供的是任务、环境和 verifier 的组织方式,不会自动保证任务质量。Expected issue 是否清楚、verifier 是否误判,仍然需要作者负责。
怎样理解 30% 与 0.32
LangChain 文章披露,首轮人工检查中,ReviewBench 的 verifier 对一批 finding 的判断约有 30% 不正确。这个数字最重要的含义不是“自动评分不可靠”,而是 verifier 本身也必须被评测、修订和回归。
Luna 的 0.32 来自 20-task slice 上的 tuned Luna 配置,每个任务运行三次。官方说明该配置使用 high reasoning effort 和结构化 review prompt;与此同时,它没有新增工具,并把与原配置相比的核心新增部分描述为新的审查提示词。
因此,这个结果应被理解为一次 harness comparison:模型、提示词、推理设置、执行环境和 verifier 共同构成被比较的系统。它不是纯模型排名,也不能把提升单独归因于 reasoning effort。
从 5–10 个真实 PR 开始
独立开发者不需要先构建大规模 benchmark。更务实的起点,是从过去已经合并或修复的 PR 中挑选 5–10 个任务。
优先选择这些案例:
- 问题已经被人工确认;
- 影响明确,不只是代码风格偏好;
- 需要理解仓库上下文,而不是搜索一个关键词;
- 修复前后的行为可以验证;
- 未来类似改动仍可能重现。
每个任务至少记录六项:PR 改动、隐含契约、expected issue、合格 finding、无效 finding 和 verifier。这样做的目的不是追求一个漂亮总分,而是建立“哪些失败不能再发生”的可执行清单。
Omnihex 方法卡:生产 RSS 混入草稿
下面是一个多语言知识站的最小示例。它是 Omnihex 方法示例,不是 ReviewBench 官方任务。
案例:生产 RSS 混入草稿
PR 改动: 重构内容过滤逻辑,把多处列表查询合并到共享函数。
隐含契约: Production RSS 必须排除draft: true;Preview 可以渲染草稿,但不得进入生产 feed。
Expected issue: 新共享函数在 RSS 调用路径中没有应用生产草稿过滤,导致草稿条目进入/zh/rss.xml。
合格 finding: 指出 RSS 生成器调用共享查询后遗漏draft === false条件,并说明生产订阅者会看到未发布内容。
无效 finding: “建议检查草稿状态”或“这里可能需要更多测试”。它们没有指出位置、行为变化和生产影响。
Verifier: 同时检查 finding 是否定位 RSS 调用路径、是否识别过滤缺失、是否说明草稿公开暴露;缺少任一项则不判定为完整命中。
这张卡的价值,在于把一次仓库特有的失败压缩成可复用任务。下一次更换模型、prompt 或工具配置时,可以重新运行,而不是依靠“这次看起来审得不错”的印象。
最小失败分类与回归记录
单一分数不够解释 Agent 为什么失败。至少要区分:
- Missed:完全没有发现 expected issue;
- Vague:方向接近,但没有给出可行动的位置或影响;
- Wrong impact:发现了代码变化,却错误判断后果;
- False positive:提出与真实契约无关的问题;
- Verifier error:Agent 已经命中,但 verifier 判错;
- Environment failure:任务因依赖、工具或仓库状态无法正常执行。
回归记录可以保持很小:
| 字段 | 记录内容 |
|---|---|
| Task ID | 稳定任务标识,与原 PR 关联 |
| Candidate | 模型、prompt、reasoning 与工具配置 |
| Trials | 每次运行的 finding 和时间 |
| Verdict | 命中、部分命中、未命中或无法执行 |
| Failure class | 使用固定失败分类 |
| Verifier version | 记录评分逻辑版本,避免静默漂移 |
| Notes | 人工复核理由和下一步修改 |
只有保存这些信息,后续配置变化才有可比较的基线。
当前边界
截至 2026-08-10,本轮未找到可供外部完整下载和复跑的公开 ReviewBench 数据集。这是本轮检索边界,不代表数据集以后不会公开,也不影响公开文章中方法层面的参考价值。
同时,20-task slice 的结果不能外推为所有代码审查场景的稳定排名;内部 LangSmith monorepo 的任务分布也不等同于你的仓库。最稳妥的用法,是把 ReviewBench 当作评测设计案例,把 Harbor 当作任务组织参考,再用自己的真实 PR 建立回归集。
结论
公开 benchmark 帮你比较共同任务,仓库回归集帮你守住自己的真实契约。先从 5–10 个已经发生过、影响明确的 PR 失败开始,为每个任务写清 expected issue、合格 finding 和 verifier;然后再比较模型、prompt 与执行配置。
真正有决策价值的回归集,仍要从自己的失败历史开始。